


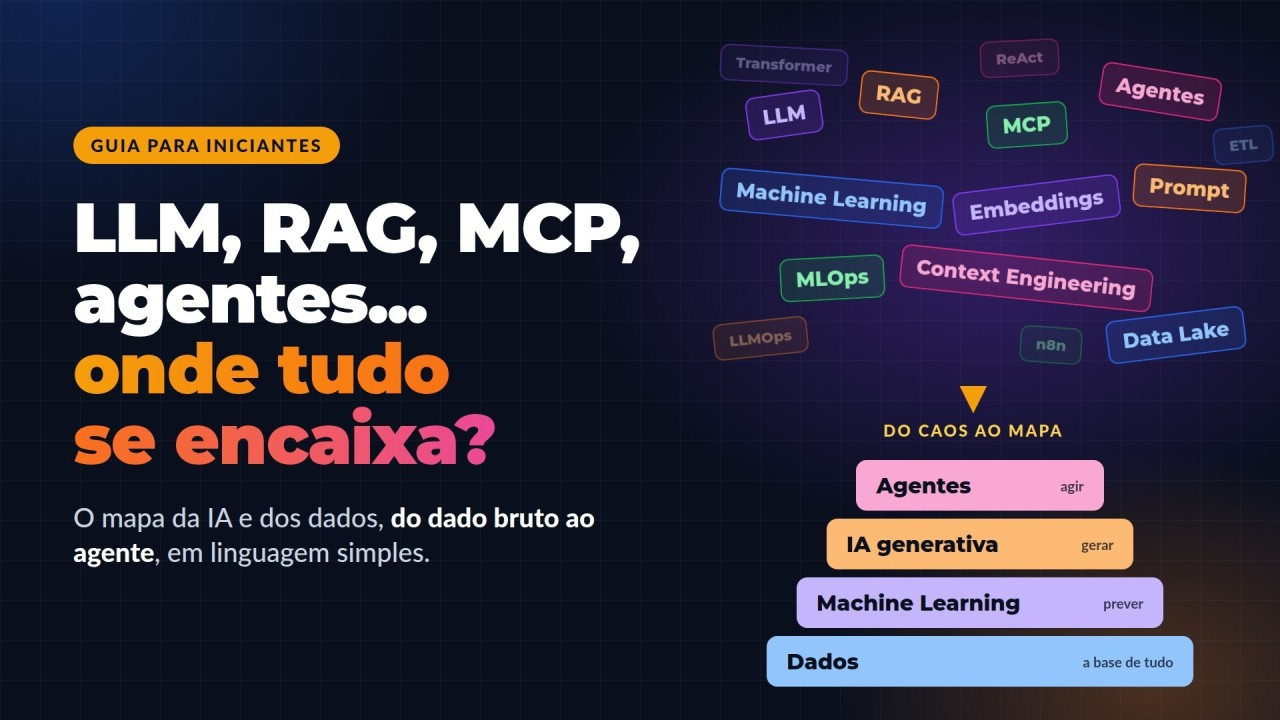
Um guia para entender onde cada peça se encaixa, do dado ao agente.

Por onde começar quando tudo parece ser IA?
Machine Learning, Deep Learning, LLM, RAG, agentes, MCP, embeddings, engenharia de prompt, engenharia de contexto, MLOps, n8n, PyTorch, LangGraph, Data Lake, Data Mesh…
Para quem está começando, a maior dificuldade costuma não ser aprender cada termo, e sim entender onde cada conceito se encaixa, qual problema ele resolve e como se relaciona com os demais. Este artigo tem esse objetivo. Ele funciona como guia introdutório e como catálogo de referência: você pode lê-lo do início ao fim para ter uma visão geral ou voltar a uma seção sempre que encontrar um termo novo.
A ideia central: IA não é uma tecnologia isolada. É um ecossistema que envolve problemas, dados, modelos, software, ferramentas, pessoas, processos e infraestrutura.
O mapa geral: onde tudo se encaixa?
Antes de estudar cada termo, vale construir um mapa mental.

O mapa é uma simplificação. As setas indicam dependências comuns, não uma hierarquia rígida: nem toda solução usa todas as peças, existem modelos generativos que não são LLMs e nem todo modelo de IA usa a arquitetura Transformer.
Ele já mostra uma ideia importante: dados e IA estão profundamente conectados. Uma aplicação de IA pode começar em um pipeline de dados, usar dados estruturados ou documentos, aplicar um modelo de ML ou um LLM e terminar em um dashboard, uma previsão, uma resposta, uma automação ou uma ação executada por um agente.
1. Do dado ao consumo: a jornada que sustenta a IA
Um erro comum de quem começa em IA é imaginar que o projeto começa pela escolha do modelo. Na prática, ele começa muito antes, nos dados.

Repare em dois detalhes da figura: o pipeline não é uma etapa isolada, e sim o mecanismo que automatiza e orquestra todas as etapas; e a qualidade e governança valem para a jornada inteira, não apenas para o final.
1.1 Ingestão de dados
É o processo de coletar dados de diferentes fontes e levá-los para um ambiente onde possam ser armazenados e processados (UDS Tecnologia, 2026). A ingestão pode ser:
- em lote (batch): os dados são trazidos em intervalos definidos, por exemplo, uma vez por dia;
- em fluxo contínuo (streaming): os dados são trazidos à medida que os eventos acontecem.
Fontes comuns: APIs, bancos de dados, arquivos CSV e JSON, sistemas ERP e CRM, aplicações SaaS, eventos, sensores e logs.
1.2 Armazenamento
Os dados podem ser guardados em diferentes arquiteturas:
- Data Lake: repositório flexível para grandes volumes de dados em formatos variados, geralmente em armazenamento de objetos (object storage). Exemplos: arquivos CSV, JSON, Parquet, imagens, PDFs e logs.
- Data Warehouse: repositório estruturado e otimizado para consultas analíticas e BI. Exemplo: tabelas de vendas, clientes e produtos usadas por dashboards.
- Data Lakehouse: arquitetura que guarda os dados em formatos abertos, como em um data lake, mas acrescenta recursos típicos de um data warehouse, como transações, controle de versões e bom desempenho em consultas (Armbrust et al., 2021).
Um quarto termo aparece com frequência: Data Mesh. Ele não é uma tecnologia de armazenamento, mas uma forma de organização: cada área de negócio (domínio) é responsável pelos próprios dados e os disponibiliza como produtos para o restante da empresa (Dehghani, 2022).
1.3 Transformação de dados
Transformar dados significa alterar sua estrutura ou conteúdo para torná-los úteis. Ferramentas comuns são SQL, Pandas, PySpark e serviços como o AWS Glue. Exemplos:
- remover duplicidades;
- tratar valores ausentes;
- padronizar datas;
- juntar tabelas;
- calcular métricas;
- criar novas variáveis para modelos (features);
- converter formatos.
Dois termos aparecem muito aqui:
- ETL (Extract, Transform, Load): extrai, transforma e depois carrega no destino;
- ELT (Extract, Load, Transform): extrai, carrega e transforma dentro do próprio destino, comum em data warehouses e lakehouses modernos.
1.4 Qualidade e governança
Dados errados geram análises, modelos e respostas erradas. Por isso, a jornada precisa de:
- qualidade de dados: verificar se os dados estão corretos, completos e atualizados;
- catálogo e metadados: saber quais dados existem, o que significam e de onde vêm;
- segurança e acesso: definir quem pode ver ou alterar cada dado;
- conformidade: respeitar leis e políticas, como a LGPD no caso de dados pessoais.
1.5 Pipeline de dados
É a sequência automatizada de etapas que leva os dados da origem até quem vai usá-los. Ou seja: a ingestão traz os dados; o pipeline organiza e automatiza o fluxo completo.

1.6 Camada de dados e consumo
Depois de transformados, os dados costumam ser organizados em camadas conforme o nível de tratamento. Um padrão comum tem três níveis: bronze (dados brutos), prata (dados limpos e padronizados) e ouro (dados prontos para consumo, como indicadores e tabelas de negócio).
Consumo é o uso desses dados por pessoas, aplicações, modelos ou processos. Essa etapa é importante porque o objetivo de uma arquitetura de dados não é apenas guardar dados, e sim permitir que sejam usados.

Exemplos:
- um dashboard usa dados para apoiar decisões;
- um modelo de ML usa dados para fazer previsões;
- um sistema RAG usa documentos para dar contexto a um LLM;
- um agente de IA acessa dados por meio de APIs e ferramentas.
O valor aparece quando os dados são usados para gerar informação, previsão, decisão ou ação.
1.7 Ferramentas de engenharia de dados
Processar grandes volumes de dados exige ferramentas diferentes das usadas para analisar um arquivo pequeno no computador. Alguns exemplos:
- PySpark: interface Python do Apache Spark para processar grandes volumes de dados de forma distribuída, por exemplo, em ETLs.
- AWS Glue: serviço gerenciado da AWS para integração, catalogação e transformação de dados.
- AWS Glue DataBrew: ferramenta visual, sem código, para limpar e preparar dados.
- Amazon SageMaker Data Wrangler: ferramenta de preparação de dados para ML, hoje integrada ao Amazon SageMaker Canvas (Amazon Web Services, 2026a).
2. Analytics: transformar dados em informação
Depois de coletados e organizados, os dados podem ser analisados para responder a diferentes perguntas. A análise de dados (analytics) costuma ser dividida em quatro níveis, do mais simples ao mais avançado:

Os níveis preditivo e prescritivo já costumam usar modelos de Machine Learning, o que mostra como analytics e IA se complementam.
2.1 Ferramentas de BI
Ferramentas de BI (business intelligence) transformam dados em visualizações, como dashboards e relatórios, para apoiar a tomada de decisão. Exemplos:
- Amazon Quick Sight, parte do Amazon Quick (antigo Amazon QuickSight);
- Microsoft Power BI;
- Apache Superset;
- Tableau;
- Looker.
3. Inteligência Artificial, Machine Learning e Deep Learning
Esses termos são frequentemente usados como sinônimos, mas um está contido no outro.

3.1 Inteligência Artificial (IA)
É o campo da computação dedicado a criar sistemas capazes de executar tarefas associadas à inteligência humana, como perceber, aprender, raciocinar e tomar decisões (Russell; Norvig, 2022). É o conceito mais amplo e inclui abordagens que não aprendem com dados, como sistemas baseados em regras e algoritmos de busca. Exemplos de aplicações:
- reconhecimento de imagens;
- recomendação de produtos;
- previsão de demanda;
- processamento de linguagem;
- geração de texto e de imagens;
- agentes que executam tarefas.
3.2 Machine Learning (ML)
É uma subárea da IA em que algoritmos aprendem padrões a partir de dados, em vez de seguir regras escritas manualmente. O processo tem duas fases: treinamento, em que o modelo aprende com dados históricos, e inferência, em que o modelo treinado é usado em casos novos.

3.3 Principais tipos de aprendizado

3.4 Problemas comuns de ML
- Classificação: prevê uma categoria. Exemplo: fraude ou não fraude.
- Regressão: prevê um valor numérico. Exemplo: preço de uma casa.
- Clusterização: encontra grupos semelhantes. Exemplo: segmentação de clientes.
- Detecção de anomalias: encontra comportamentos incomuns. Exemplo: transações suspeitas.
- Recomendação: sugere itens. Exemplo: filmes ou produtos.
- Previsão de séries temporais (forecasting): prevê valores futuros com base no histórico. Exemplo: demanda de energia.
3.5 Deep Learning (DL)
É uma subárea de ML baseada em redes neurais com muitas camadas. O deep learning foi a base de grandes avanços em:
- visão computacional;
- reconhecimento de voz;
- tradução automática;
- processamento de linguagem;
- modelos generativos.
3.6 Frameworks e bibliotecas de ML e DL
São as ferramentas usadas para preparar dados e criar, treinar e usar modelos de ML e DL por meio de código.

4. Transformer, modelos de linguagem e IA generativa
4.1 Transformer: a arquitetura que mudou a IA moderna
Um marco fundamental foi o artigo “Attention Is All You Need”, que apresentou a arquitetura Transformer, baseada no mecanismo de atenção (Vaswani et al., 2017). A atenção permite que o modelo avalie, para cada palavra, quais outras partes do texto são mais relevantes. O Transformer se tornou a principal base dos modelos de linguagem atuais e também influenciou modelos multimodais (modelos de IA que trabalham com mais de um tipo de dado ao mesmo tempo, como texto, imagem, áudio, etc.).
Exemplos de famílias baseadas em Transformer: para gerar texto, GPT (OpenAI), Claude (Anthropic), Gemini (Google), Llama (Meta), Qwen (Alibaba), DeepSeek e Mistral; para compreender texto (classificação e busca), o BERT e sua versão atualizada, o ModernBERT, além dos modelos de embedding usados no RAG.

Um ponto importante: um LLM gera texto um token por vez. A cada passo, ele estima as probabilidades do próximo token, escolhe um, acrescenta ao texto e repete o processo.
4.2 Foundation Models, LLMs e IA generativa
Esses três conceitos se relacionam, mas não são sinônimos:
- Foundation model (modelo de fundação): modelo treinado com grandes volumes e variedades de dados que pode ser adaptado a muitas tarefas diferentes (Bommasani et al., 2021). O termo surgiu com modelos como BERT, GPT-3 e DALL-E. Hoje, os exemplos vão além do texto: os LLMs multimodais, como Gemini e Llama, e o SAM (Segment Anything), da Meta, que recorta qualquer objeto em imagens e vídeos, inclusive objetos que não viu no treinamento (Kirillov et al., 2023).
- LLM (Large Language Model): modelo de linguagem de grande escala, capaz de compreender e gerar texto. Exemplos de famílias: GPT, Claude, Gemini e Llama. Muitos LLMs também são foundation models.
- IA generativa (GenAI): categoria de modelos e sistemas capazes de gerar conteúdo novo, como texto, imagens, áudio e vídeo. O LLM é um tipo de modelo generativo especializado em linguagem. Muitos modelos generativos usam Transformers, mas há outras arquiteturas, como os modelos de difusão usados em imagens.
4.3 Token e embedding
Dois conceitos ajudam a entender como um modelo processa um texto:
- Token: pedaço de texto processado pelo modelo. Pode ser uma palavra, parte de uma palavra ou um sinal de pontuação.
- Embedding: representação numérica (um vetor) de um conteúdo. Conteúdos com significado parecido ficam próximos nesse espaço numérico, o que torna os embeddings fundamentais para a busca semântica e para o RAG.
5. Engenharia de prompt e engenharia de contexto
5.1 Engenharia de prompt (prompt engineering)
Responde principalmente à pergunta: “Como devo instruir o modelo?”
É a prática de escrever e testar instruções para orientar o comportamento de um modelo de linguagem. Um bom prompt reduz a ambiguidade porque deixa claros a tarefa, o contexto, as restrições e o formato esperado.

Exemplo: em vez de “analise este texto”, prefira “Resuma o texto em até cinco tópicos, destaque os argumentos principais e não acrescente informações que não estejam no material”.
Engenharia de prompt é um processo iterativo: escreva, teste com entradas diferentes, observe as falhas e ajuste. Instruções claras e exemplos ajudam, mas não garantem uma resposta correta. Informações importantes devem ser verificadas, principalmente em tarefas de maior risco.
5.2 Engenharia de contexto (context engineering)
A engenharia de contexto é a evolução natural da engenharia de prompt: em vez de cuidar só da instrução, ela cuida de tudo o que entra na janela de contexto do modelo a cada execução (Rajasekaran et al., 2025).

Mais contexto nem sempre é melhor. Conteúdo irrelevante distrai o modelo, aumenta o custo e ocupa espaço. Além disso, a capacidade do modelo de usar bem as informações tende a cair à medida que o contexto cresce, fenômeno chamado de context rot. Por isso, a recomendação é buscar o menor conjunto de informações relevantes que permita realizar a tarefa (Rajasekaran et al., 2025). Boas práticas:
- priorizar informações diretamente ligadas à tarefa;
- separar as instruções dos dados enviados pelo usuário ou recuperados de fontes externas;
- indicar a origem e, quando relevante, a data dos dados;
- manter o histórico necessário e descartar o que deixou de ser útil;
- respeitar o limite da janela de contexto e o orçamento de tokens.
Engenharia de prompt: cuida da instrução, ou seja, de como o modelo deve agir. Engenharia de contexto: cuida de todas as informações disponíveis para o modelo realizar a tarefa.
6. RAG: conectar LLMs a conhecimento externo
RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação) combina um modelo generativo com uma fonte externa de conhecimento (Lewis et al., 2020). Em vez de depender só do que aprendeu no treinamento, o sistema busca informações relacionadas à pergunta e as entrega ao modelo como contexto.

6.1 Etapas de um sistema RAG
- Preparar a base: coletar e limpar os documentos e dividi-los em trechos (chunks) que mantenham sentido completo.
- Indexar: gerar representações dos trechos, como embeddings, e guardá-las com seus metadados em um mecanismo de busca. A busca pode ser por palavras-chave, por significado (semântica) ou uma combinação das duas (híbrida).
- Recuperar: usar a pergunta para encontrar os trechos mais úteis. Filtros por metadados e reordenação dos resultados (reranking) ajudam a melhorar a relevância.
- Gerar: entregar ao LLM a pergunta e os trechos, orientando-o a responder com base nessas evidências e a dizer quando a informação não estiver disponível.
- Avaliar e atualizar: verificar a qualidade da busca e das respostas e atualizar a base quando as fontes mudarem.
6.2 Exemplo
“Qual é a política de reembolso da empresa?”
O sistema busca a política vigente na documentação interna e entrega os trechos relevantes ao LLM. A resposta deve refletir essas fontes e não inventar regras quando os documentos não tratarem do assunto.
6.3 Quando o RAG é útil e quais são seus limites
O RAG é útil quando a resposta depende de informações privadas, atualizadas ou específicas de um domínio, como manuais internos, catálogos e documentação técnica. Ele também facilita mostrar as fontes usadas, o que ajuda a verificar a resposta.
Porém, o RAG não garante precisão. A resposta pode falhar se a base estiver desatualizada, se a busca trouxer trechos inadequados ou se o modelo interpretar mal as evidências. Por isso, avalie a busca e a geração separadamente, controle quem pode acessar cada documento e oriente o sistema a reconhecer quando não há evidência suficiente.
Resumo: a qualidade de um RAG depende do modelo, mas também da qualidade da base, da estratégia de busca e da forma como o contexto é montado.
7. Assistentes de IA e agentes de IA
7.1 Assistente de IA
É um sistema que responde ao usuário a cada pedido. Ele pode usar ferramentas, mas a interação é conduzida pela pessoa, passo a passo. Exemplos de uso:
- resumir documentos;
- responder perguntas;
- escrever textos;
- analisar informações;
- explicar código.
7.2 Agente de IA
É um sistema em que o modelo decide dinamicamente os próprios passos e quais ferramentas usar para atingir um objetivo (Schluntz; Zhang, 2024). O agente recebe um objetivo, divide a tarefa em etapas, usa ferramentas, observa os resultados e decide o que fazer em seguida, até concluir ou atingir um limite.

Exemplo: “Analise minhas vendas do último trimestre e descubra os produtos que mais perderam receita.” O agente pode consultar o banco de dados, executar um script Python, gerar gráficos, conferir os números e produzir um relatório.
Vale distinguir agente de workflow: em um workflow, os passos são definidos previamente no código; em um agente, o modelo escolhe os passos durante a execução. A recomendação é começar pela solução mais simples possível e só adicionar autonomia quando ela trouxer ganho real, pois agentes tendem a custar mais e a ser menos previsíveis (Schluntz; Zhang, 2024).
7.3 Sistemas multiagentes
Um sistema multiagente (multi-agent) distribui o trabalho entre vários agentes especializados. Exemplo de divisão:
- agente pesquisador;
- agente analista;
- agente redator;
- agente revisor.
Atenção: mais agentes não significa um sistema melhor. Se um workflow simples ou um único agente resolve o problema, adicionar agentes pode apenas aumentar o custo, a latência e a complexidade.
7.4 Habilidades, ferramentas, memória e planejamento
Quatro conceitos aparecem com frequência na arquitetura de agentes.

- Habilidade (skill): conjunto reutilizável de instruções, scripts e materiais de apoio que ensina o agente a executar um tipo de tarefa. Exemplo: “gerar o relatório semanal de vendas no formato da empresa”. O formato Agent Skills, criado pela Anthropic, organiza cada habilidade em uma pasta com um arquivo SKILL.md e recursos opcionais; ele se tornou um padrão aberto e foi doado à Agentic AI Foundation (Anthropic, 2026).
- Ferramenta (tool): função, API ou programa que o agente pode chamar para obter dados ou agir. Exemplos: executar uma consulta SQL, chamar uma API ou rodar um script Python.
- Memória (memory): informações guardadas para manter o contexto durante uma tarefa ou entre conversas. Exemplo: preferências do usuário ou decisões anteriores.
- Planejamento (planning): divisão de um objetivo em etapas, com a possibilidade de ajustar o plano conforme os resultados.
7.5 Frameworks e ferramentas para LLMs e agentes
Essas opções ajudam a integrar modelos, ferramentas e workflows. Nem todas são frameworks de agentes: algumas são bibliotecas de apoio.

8. MCP: Model Context Protocol
O MCP (Model Context Protocol) é um padrão aberto para conectar aplicações de IA a sistemas externos, como arquivos, bancos de dados, ferramentas e fluxos de trabalho (Model Context Protocol, 2026a). Uma analogia útil: o MCP funciona como uma “porta USB-C” para aplicações de IA. Em vez de criar uma integração diferente para cada combinação de aplicação e sistema, cada sistema expõe um servidor MCP e qualquer aplicação compatível pode usá-lo.
O protocolo foi lançado pela Anthropic em novembro de 2024 e, em dezembro de 2025, foi doado à Agentic AI Foundation, ligada à Linux Foundation (Model Context Protocol, 2025a).

8.1 Como a arquitetura funciona
O MCP adota uma arquitetura host–cliente–servidor (Model Context Protocol, 2026b):
- Host: a aplicação de IA que o usuário utiliza, como um assistente, uma IDE ou um agente. Ela coordena tudo e controla as permissões.
- Cliente MCP: componente dentro do host que mantém a conexão com um servidor MCP.
- Servidor MCP: programa que expõe capacidades de um sistema, como ler arquivos autorizados, consultar um banco de dados ou chamar uma API.
Um host pode ter vários clientes, um para cada servidor. Cada servidor deve ter uma responsabilidade clara e receber apenas as informações necessárias para sua função.
8.2 O que um servidor MCP pode oferecer

Em resumo: tools executam operações, resources fornecem contexto e prompts oferecem instruções prontas. As ferramentas são pensadas para que o modelo decida quando chamá-las, mas a especificação recomenda que sempre haja uma pessoa capaz de negar a execução (Model Context Protocol, 2025b).
8.3 Exemplo de fluxo
Imagine que uma pessoa pergunte: “Qual é o status do pedido 123?”.

O MCP padroniza a comunicação entre cliente e servidor. Ele não é um agente, nem um modelo de IA, nem uma garantia de segurança. A aplicação continua responsável por decidir o que fazer com os resultados e por controlar ações que alterem dados ou tenham efeitos externos.
8.4 Segurança e boas práticas
- Conecte-se somente a servidores confiáveis e verifique quais dados e operações cada um oferece.
- Conceda o mínimo de permissões; prefira acesso somente leitura quando a tarefa não exigir alterações.
- Trate o conteúdo devolvido por ferramentas e recursos como dado externo: ele pode estar errado ou conter instruções maliciosas.
- Peça confirmação antes de ações sensíveis ou difíceis de reverter, como excluir dados, enviar mensagens ou fazer pagamentos.
- Proteja credenciais e tokens de acesso: não os exponha ao modelo nem os reutilize em serviços diferentes.
- Registre e monitore as chamadas relevantes, sem guardar dados pessoais ou segredos sem necessidade.
Em resumo: o MCP facilita as integrações, mas autenticação, autorização, validação e supervisão continuam sendo responsabilidade de quem constrói a solução.
9. CoT e ReAct
9.1 CoT (Chain-of-Thought)
Chain-of-Thought (cadeia de pensamento) é uma técnica que leva o modelo a resolver o problema em etapas intermediárias antes de dar a resposta final (Wei et al., 2022). Ela melhora o desempenho em tarefas de matemática, lógica, planejamento e análise que exigem vários passos. Hoje, muitos modelos de raciocínio (reasoning models) já fazem esse processo internamente, sem que o usuário precise pedir.
Problema → etapa 1 → etapa 2 → etapa 3 → resposta
Cuidado: as etapas exibidas pelo modelo ajudam a entender a resposta, mas não são uma prova de que ela está correta. O resultado final continua precisando de verificação.
9.2 ReAct (Reasoning and Acting)
ReAct é uma abordagem que alterna raciocinar, agir com uma ferramenta e observar o resultado para decidir o próximo passo (Yao et al., 2023). É o padrão por trás de muitos agentes de IA.
Objetivo → raciocinar → usar ferramenta → observar → raciocinar → … → responder

9.3 Diferença principal
CoT = raciocinar em etapas. ReAct = raciocinar + agir + observar.

10. Determinístico e não determinístico
Essa diferença ajuda a entender por que sistemas de IA precisam de validação.
10.1 Determinístico
Um sistema determinístico produz sempre o mesmo resultado para a mesma entrada, nas mesmas condições. Exemplos: consultas SQL, cálculos e regras de negócio, desde que os dados não mudem.
10.2 Não determinístico
Em um sistema não determinístico, a mesma entrada pode gerar resultados diferentes. É o caso típico dos LLMs: como o próximo token é sorteado a partir de probabilidades (amostragem), duas execuções podem gerar textos diferentes. Mesmo com a temperatura em zero, as respostas podem variar por detalhes da infraestrutura, como a forma de agrupar requisições no servidor (He; Thinking Machines Lab, 2025).
10.3 Sistemas híbridos
Na prática, sistemas robustos combinam os dois. O LLM interpreta a entrada, e componentes de software tradicionais aplicam as regras críticas e fazem os cálculos de forma verificável. Essa divisão também reduz chamadas ao modelo e, com isso, o consumo de tokens.

10.4 Modelos tradicionais de ML são determinísticos?
Em geral, sim na previsão: um modelo já treinado (como regressão logística, árvore de decisão ou Random Forest) dá a mesma resposta para a mesma entrada. A aleatoriedade costuma estar no treinamento, por exemplo, na inicialização dos parâmetros, na amostragem dos dados ou na divisão entre treino e teste. Fixar uma semente aleatória (seed) torna o treinamento reproduzível.
Resumindo: ML tradicional tende a ser determinístico na previsão; LLMs são probabilísticos na geração de texto.
10.5 Casos clássicos: fraude e análise de crédito
Esses problemas costumam combinar modelos e regras. O modelo estima um risco, e regras de negócio transformam esse risco em uma decisão.

Considerações:
- O modelo gera um score de risco, por exemplo, 0,87. Esse valor só deve ser lido como probabilidade se o modelo tiver sido calibrado e validado para isso.
- Uma camada de regras converte o score em decisão. Exemplo: score ≥ 0,80 → bloquear; entre 0,50 e 0,79 → revisão humana; abaixo de 0,50 → aprovar.
- Com os mesmos dados e o mesmo modelo, a decisão é a mesma, o que facilita auditoria, explicação e conformidade (compliance).
Modelos comuns nesse tipo de problema:

11. Automação com IA
Automação conecta eventos, regras e ações para executar tarefas repetitivas com menos trabalho manual. A IA entra quando uma etapa exige interpretar texto, classificar conteúdo, extrair informações ou redigir uma resposta. Nem todo workflow precisa de IA: quando o processo é claro e previsível, regras tradicionais são mais simples, baratas e fáceis de auditar.

Um workflow com IA combina partes probabilísticas e determinísticas: o modelo interpreta uma mensagem ou sugere uma categoria, e as regras validam o resultado antes da ação. Em tarefas sensíveis, peça confirmação humana em vez de executar automaticamente.
11.1 Componentes de um workflow
- Gatilho (trigger): evento que inicia o fluxo, como um novo e-mail, formulário ou registro.
- Condições e regras: verificações, filtros e caminhos alternativos.
- Etapa de IA (opcional): interpretação, classificação, extração ou geração de conteúdo.
- Ação: chamada de API, atualização de sistema, notificação ou criação de tarefa.
- Tratamento de falhas: novas tentativas controladas, caminhos de exceção e encaminhamento para revisão humana.
- Observabilidade: registros, métricas e alertas sobre sucesso, erros, latência e custo.
11.2 n8n e outras plataformas
O n8n é uma plataforma de automação de workflows que conecta aplicações, APIs, bancos de dados e componentes de IA por meio de uma interface visual. Make, Zapier e Power Automate oferecem recursos semelhantes, com diferenças de integrações, forma de implantação, governança e custo.

12. Assistentes de código, assistentes generalistas e harness
12.1 Assistentes e agentes de código
Ferramentas de IA para programação ajudam a:
- gerar e explicar código;
- criar testes;
- corrigir erros;
- refatorar código;
- navegar por repositórios.
Exemplos: GitHub Copilot, Claude Code e Devin (da Cognition).
Hoje, a diferença entre “assistente” e “agente” de código está mais no modo de uso do que no produto. O GitHub Copilot, por exemplo, sugere código enquanto você digita, mas também tem um modo agente, no qual planeja e executa alterações em vários arquivos, roda comandos e corrige erros (GitHub, 2026). Em qualquer modo, as alterações devem ser revisadas e testadas.

12.2 Assistentes generalistas
Um assistente generalista apoia tarefas em vários domínios: pesquisa, escrita, programação, documentos, análise, planejamento e automação.
O OpenClaw é um exemplo: trata-se de um agente de IA pessoal e de código aberto, que roda nos dispositivos do próprio usuário e pode ser acessado por diferentes aplicativos de mensagem (OpenClaw, 2026). Como em qualquer agente, o nível de autonomia e de segurança depende da configuração e das permissões concedidas.
12.3 Harness (ambiente do agente)
O harness é toda a camada de software que envolve o modelo e permite que ele funcione como agente: instruções, gerenciamento de contexto, ferramentas, memória, permissões e verificações (Google Cloud, 2026a). Uma forma simples de lembrar:

Por isso, um agente não é apenas um LLM: com o mesmo modelo, um harness bem construído pode gerar resultados muito melhores do que um mal construído.
13. MLOps
MLOps é o conjunto de práticas para levar modelos de ML do experimento à produção e mantê-los funcionando bem ao longo do tempo.

13.1 Conceitos essenciais
- Registro de modelos (model registry): repositório central que guarda as versões dos modelos, seus metadados e o status de implantação.
- Data drift: a distribuição dos dados de entrada muda em relação aos dados de treinamento. Exemplo: o perfil dos clientes muda.
- Concept drift: muda a relação entre os dados e o resultado. Exemplo: fraudadores adotam táticas novas, e os mesmos sinais deixam de indicar fraude.
- Model drift: queda no desempenho do modelo ao longo do tempo, geralmente causada pelos dois tipos de drift acima (Wornow et al., [2025?]). Exemplo: aumento de falsos positivos em fraude.
- Versionamento: controle das versões de código, dados, modelos e configurações. Facilita reproduzir resultados, auditar e voltar a uma versão anterior (rollback).
- CI/CD: automação para integrar, testar e entregar mudanças. Em ML, pode incluir treinamento, avaliação e implantação automáticos.
- Monitoramento: acompanhamento contínuo de modelos, dados, infraestrutura e métricas de negócio em produção.
- Avaliação: medição da qualidade do modelo com dados que não foram usados no treinamento. Exemplos de métricas: accuracy, precision, recall, F1, ROC-AUC e RMSE.
13.2 Plataformas de MLOps
- Amazon SageMaker AI, nome atual do Amazon SageMaker original (Amazon Web Services, 2026b);
- Azure Machine Learning;
- Gemini Enterprise Agent Platform, nome atual da antiga plataforma Vertex AI do Google Cloud (Google Cloud, 2026b);
- Databricks;
- MLflow (código aberto).
14. LLMOps
LLMOps (Large Language Model Operations) adapta as práticas de MLOps às aplicações com LLMs: desenvolver, avaliar, implantar, monitorar e manter essas aplicações em produção (Seyffert, 2026). A diferença é que, em vez de cuidar só do modelo, o LLMOps trata a aplicação como um sistema completo. Os principais itens acompanhados são:
- Prompts: versionar e testar as instruções, pois pequenas mudanças alteram o comportamento.
- Contexto: controlar o que entra na janela de contexto (histórico, memória, documentos e resultados de ferramentas).
- Modelos: gerenciar quais LLMs são usados, suas versões e configurações.
- Tokens e custos: medir o consumo de tokens de entrada e saída, que define o custo e o uso da janela de contexto.
- Latência: acompanhar o tempo de resposta.
- Ferramentas: controlar quais APIs, bancos e sistemas o LLM pode usar.
- Documentos recuperados: avaliar relevância, qualidade e atualização das fontes do RAG.
- Qualidade das respostas: medir precisão, relevância, consistência e segurança, com métricas automáticas e revisão humana.

O LLMOps não substitui o MLOps: ele amplia suas práticas para lidar com o que é específico das aplicações com LLMs.
14.1 Plataformas de LLMOps
Há ferramentas criadas especificamente para LLMOps, mas muitas plataformas de MLOps também passaram a oferecer esses recursos.

“Secundário” indica que a área não é o foco principal da ferramenta. Recursos variam conforme o produto, o plano e a versão.
15. Avaliação, confiabilidade e segurança
15.1 Avaliação e confiabilidade
Avaliar não é apenas ver se uma resposta “parece certa”. É preciso definir o que é sucesso no caso de uso, escolher métricas adequadas e testar o sistema com exemplos parecidos com os do mundo real. Como a mesma entrada pode gerar respostas diferentes, é importante repetir testes e observar o comportamento em um conjunto de casos, e não em uma única resposta.

15.2 Como organizar a avaliação
- Defina o objetivo e o risco: o que é uma resposta ou ação aceitável e quais erros são mais graves.
- Monte um conjunto de casos de teste: inclua casos comuns, difíceis, incompletos e inesperados. No RAG, inclua perguntas cuja resposta está e não está na base.
- Escolha métricas adequadas: uma única métrica raramente basta. Em fraude, por exemplo, deixar passar uma fraude custa diferente de bloquear uma compra legítima.
- Compare versões: rode os mesmos casos sempre que mudar modelo, prompt, dados, índice de busca ou ferramentas.
- Combine avaliação automática e humana: a automática permite escala; a humana avalia nuances como clareza e utilidade.
- Monitore em produção: acompanhe qualidade, erros, latência, custo e mudanças de comportamento. A avaliação antes do lançamento não substitui o monitoramento.
No RAG, avalie separadamente a busca (os trechos certos foram encontrados?) e a geração (a resposta usou bem as evidências?). Em agentes, registre a sequência de decisões e chamadas de ferramentas para descobrir em que etapa a tarefa falhou.
Boa prática: trate avaliações como testes de software. Mantenha casos de referência, registre os resultados e repita a avaliação a cada mudança relevante.
15.3 Segurança: poder exige controle
Quanto mais autonomia e acesso um sistema de IA tem, maior o impacto de um erro ou de uma instrução maliciosa. A segurança deve ser pensada desde o desenho da solução. Princípios importantes:
- Guardrails (barreiras de proteção): regras e verificações aplicadas às entradas, às respostas e às ações. Podem bloquear conteúdo inadequado, validar formatos ou impedir operações fora do escopo.
- Injeção de prompt (prompt injection): tentativa de manipular o modelo para ignorar instruções ou executar ações indevidas, por meio de texto enviado pelo usuário ou escondido em documentos e páginas. É o primeiro risco da lista OWASP para aplicações com LLMs (OWASP, 2025). Todo conteúdo externo deve ser tratado como dado não confiável, nunca como instrução.
- Privilégio mínimo (least privilege): dar ao agente apenas as permissões, os dados e as ferramentas necessários para a tarefa.
- Confirmação humana: exigir aprovação antes de ações sensíveis ou difíceis de reverter, como pagamentos, exclusões ou publicações.
- Proteção de dados: evitar enviar informações pessoais ou confidenciais sem necessidade e aplicar controles de acesso, retenção e mascaramento.
- Auditoria e monitoramento: registrar com segurança as decisões e chamadas de ferramentas relevantes, sem guardar dados sensíveis desnecessariamente.
Exemplo: um agente que consulta vendas deve ter acesso somente leitura aos dados necessários. Se precisar alterar um pedido ou excluir um registro, a ação deve ser bloqueada ou exigir autorização explícita de uma pessoa.
Princípio prático: trate a saída do modelo como uma sugestão a ser validada, e não como autorização automática para agir.
16. Como escolher a tecnologia certa?
Não comece com “quero construir um agente”. Comece com “qual problema estou tentando resolver?”. As perguntas a seguir ajudam a escolher a solução mais simples que resolve o problema.

16.1 A evolução natural de uma solução
Uma solução não precisa nascer complexa. Cada degrau adiciona capacidade, mas também custo, complexidade e risco. A melhor arquitetura é a que resolve o problema com o menor nível de complexidade necessário (Schluntz; Zhang, 2024).

17. Resumo prático
17.1 Um roteiro simples para começar
Se você está começando agora, não tente aprender tudo ao mesmo tempo:
- Programação: Python, Git, APIs, JSON e SQL.
- Dados: Pandas, NumPy, estatística, bancos de dados, ETL e pipelines.
- Analytics: indicadores (KPIs), análise exploratória e ferramentas de BI.
- Machine Learning: classificação, regressão, clusterização, métricas e Scikit-learn.
- Deep Learning: redes neurais, PyTorch e Transformers.
- IA generativa: LLMs, tokens, embeddings, prompts, RAG e avaliação.
- Agentes de IA: ferramentas, habilidades, planejamento, memória, MCP, ReAct e workflows.
- Produção: nuvem, APIs, MLOps, LLMOps, segurança e observabilidade.
17.2 Dez ideias para guardar
- IA é um ecossistema, não uma ferramenta.
- Sem dados de qualidade, não há IA de qualidade.
- O pipeline transforma dados brutos em dados prontos para uso (consumo).
- O dado gera valor quando é consumido.
- IA generativa também é Machine Learning: a diferença é que ela gera conteúdo novo, em vez de apenas classificar ou prever.
- O prompt é apenas uma parte do contexto.
- Skill é saber fazer; toll é o meio de agir.
- Agente é modelo + harness: contexto, ferramentas, regras e controle.
- Sistemas probabilísticos exigem avaliação e validação contínuas.
- Comece simples e aumente a autonomia só quando ela gerar valor.
18. Conclusão
Aprender IA não significa decorar dezenas de nomes de frameworks. O mais importante é construir um mapa mental do ecossistema.
No lado dos dados, o fluxo é:
fonte → ingestão → armazenamento → transformação → consumo → analytics, ML ou IA → aplicação
No lado da IA generativa, as camadas se somam:
modelo + contexto (que inclui o prompt e o RAG) + ferramentas e habilidades → agente → automação
Quando você entende esses fluxos, os termos deixam de parecer tecnologias isoladas e passam a ser peças de uma mesma arquitetura. Talvez essa seja a principal habilidade para quem está entrando no mundo da IA:
Não basta saber o que uma tecnologia faz; é preciso entender quando usá-la, onde ela se encaixa e qual problema ela resolve.
Esse é o objetivo deste guia: oferecer uma primeira visão do mapa e servir como catálogo de referência sempre que um termo novo aparecer.
Bem-vindo ao mundo da IA.
19. Próximos passos
Este guia pode ser a base de uma trilha de aprendizado com conteúdos práticos sobre:
- primeiro projeto de Machine Learning;
- primeiros passos com LLMs;
- construção de um RAG;
- criação de agentes;
- MCP na prática;
- automação com n8n;
- MLOps e LLMOps;
- avaliação de sistemas de IA;
- arquitetura de aplicações de IA em produção.
Apêndice: referência rápida e glossário
Este apêndice reúne os principais termos em um só lugar. As definições são resumidas; as seções anteriores trazem mais detalhes.
A.1 Fundamentos e dados

A.2 IA, Machine Learning e Deep Learning

A.3 IA generativa, LLMs e RAG

A.4 Assistentes, agentes e ferramentas

A.5 Operação, analytics e plataformas

Bibliografia
- AMAZON WEB SERVICES. Prepare data with Amazon SageMaker Data Wrangler in Amazon SageMaker Canvas. Seattle: AWS, 2026a. Disponível em: https://docs.aws.amazon.com/sagemaker/latest/dg/canvas-data-prep.html. Acesso em: 24 out. 2026.
- AMAZON WEB SERVICES. What is Amazon SageMaker AI? Seattle: AWS, 2026b. Disponível em: https://docs.aws.amazon.com/sagemaker/latest/dg/whatis.html. Acesso em: 24 out. 2026.
- ANTHROPIC. Donating Agent Skills to the Agentic AI Foundation. San Francisco: Anthropic, 22 out. 2026. Disponível em: https://www.anthropic.com/news/donating-agent-skills-to-the-agentic-ai-foundation. Acesso em: 24 out. 2026.
- ARMBRUST, Michael; GHODSI, Ali; XIN, Reynold; ZAHARIA, Matei. Lakehouse: a new generation of open platforms that unify data warehousing and advanced analytics. In: CONFERENCE ON INNOVATIVE DATA SYSTEMS RESEARCH, 11., 2021, [S. l.]. Proceedings […]. [S. l.]: CIDR, 2021. Disponível em: https://www.vldb.org/cidrdb/2021/lakehouse-a-new-generation-of-open-platforms-that-unify-data-warehousing-and-advanced-analytics.html. Acesso em: 24 out. 2026.
- ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. NBR 6023: informação e documentação: referências: elaboração. Rio de Janeiro: ABNT, 2018.
- ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. NBR 10520: informação e documentação: citações em documentos: apresentação. Rio de Janeiro: ABNT, 2023.
- BOMMASANI, Rishi et al. On the opportunities and risks of foundation models. [S. l.]: arXiv, 2021. arXiv:2108.07258. Disponível em: https://arxiv.org/abs/2108.07258. Acesso em: 24 out. 2026.
- CHANDRA, Sindhu. Reimagine business intelligence: Amazon QuickSight evolves to Amazon Quick Suite. Seattle: AWS Business Intelligence Blog, 9 out. 2025. Disponível em: https://aws.amazon.com/blogs/business-intelligence/reimagine-business-intelligence-amazon-quicksight-evolves-to-amazon-quick-suite/. Acesso em: 24 out. 2026.
- DEHGHANI, Zhamak. Data mesh: delivering data-driven value at scale. Sebastopol: O’Reilly Media, 2022. ISBN 9781492092384.
- GITHUB. Using agent mode. San Francisco: GitHub Docs, 2026. Disponível em: https://docs.github.com/en/copilot/how-tos/copilot-in-your-ide/use-copilot-agents/use-agent-mode. Acesso em: 24 out. 2026.
- GOOGLE CLOUD. What is an agent harness? Mountain View: Google Cloud, 2026a. Disponível em: https://cloud.google.com/discover/agent-harness. Acesso em: 24 out. 2026.
- GOOGLE CLOUD. Gemini Enterprise Agent Platform name changes. Mountain View: Google Cloud, 2026b. Disponível em: https://docs.cloud.google.com/gemini-enterprise-agent-platform/vertex-ai-name-changes. Acesso em: 24 out. 2026.
- HE, Horace; THINKING MACHINES LAB. Defeating nondeterminism in LLM inference. San Francisco: Thinking Machines Lab, 10 set. 2025. DOI: 10.64434/tml.20250910. Disponível em: https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/. Acesso em: 24 out. 2026.
- LEWIS, Patrick et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. In: ADVANCES IN NEURAL INFORMATION PROCESSING SYSTEMS, 33., 2020, [S. l.]. Proceedings […]. Red Hook: Curran Associates, 2020. Disponível em: https://proceedings.neurips.cc/paper/2020/hash/6b493230205f780e1bc26945df7481e5-Abstract.html. Acesso em: 24 out. 2026.
- MICROSOFT. Microsoft Agent Framework overview. Redmond: Microsoft Learn, 2026. Disponível em: https://learn.microsoft.com/en-us/agent-framework/overview/. Acesso em: 24 out. 2026.
- MODEL CONTEXT PROTOCOL. MCP joins the Agentic AI Foundation. [S. l.]: Model Context Protocol Blog, 9 dez. 2025a. Disponível em: https://blog.modelcontextprotocol.io/posts/2025-12-09-mcp-joins-agentic-ai-foundation/. Acesso em: 24 out. 2026.
- MODEL CONTEXT PROTOCOL. Specification: tools. Versão 2025-06-18. [S. l.]: Model Context Protocol, 2025b. Disponível em: https://modelcontextprotocol.io/specification/2025-06-18/server/tools. Acesso em: 24 out. 2026.
- MODEL CONTEXT PROTOCOL. What is the Model Context Protocol (MCP)? [S. l.]: Model Context Protocol, 2026a. Disponível em: https://modelcontextprotocol.io/docs/getting-started/intro. Acesso em: 24 out. 2026.
- MODEL CONTEXT PROTOCOL. Architecture overview. Versão 2026-07-28. [S. l.]: Model Context Protocol, 2026b. Disponível em: https://modelcontextprotocol.io/docs/learn/architecture. Acesso em: 24 out. 2026.
- OPENCLAW. Why OpenClaw. [S. l.]: OpenClaw Docs, 2026. Disponível em: https://docs.openclaw.ai/start/why-openclaw. Acesso em: 24 out. 2026.
- OWASP. LLM01:2025 Prompt Injection. [S. l.]: OWASP Gen AI Security Project, 2025. Disponível em: https://genai.owasp.org/llmrisk/llm01-prompt-injection/. Acesso em: 24 out. 2026.
- RAJASEKARAN, Prithvi; DIXON, Ethan; RYAN, Carly; HADFIELD, Jeremy. Effective context engineering for AI agents. San Francisco: Anthropic, 29 set. 2025. Disponível em: https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents. Acesso em: 24 out. 2026.
- RUSSELL, Stuart J.; NORVIG, Peter. Inteligência artificial: uma abordagem moderna. 4. ed. Rio de Janeiro: LTC, 2022. ISBN 9788595158870.
- SCHLUNTZ, Erik; ZHANG, Barry. Building effective agents. San Francisco: Anthropic, 19 dez. 2024. Disponível em: https://www.anthropic.com/engineering/building-effective-agents. Acesso em: 24 out. 2026.
- SEYFFERT, Pâmela. LLMOps. Porto Alegre: SoftDesign, 8 out. 2026. Disponível em: https://www.softdesign.com.br/blog/llmops/. Acesso em: 24 out. 2026.
- UDS TECNOLOGIA. Ingestão de dados: o que é, tipos e como funciona? [S. l.]: UDS, 2026. Disponível em: https://uds.com.br/blog/ingestao-dados/. Acesso em: 24 out. 2026.
- VASWANI, Ashish et al. Attention is all you need. In: ADVANCES IN NEURAL INFORMATION PROCESSING SYSTEMS, 30., 2017, Long Beach. Proceedings […]. Red Hook: Curran Associates, 2017. p. 5998-6008. Disponível em: https://proceedings.neurips.cc/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html. Acesso em: 24 out. 2026.
- WEI, Jason et al. Chain-of-thought prompting elicits reasoning in large language models. [S. l.]: arXiv, 2022. arXiv:2201.11903. Disponível em: https://arxiv.org/abs/2201.11903. Acesso em: 24 out. 2026.
- WORNOW, Michael; FLEMING, Scott; FRIES, Jason; SHAH, Nigam. What is model drift? Stanford: Stanford HAI, [2025?]. Disponível em: https://hai.stanford.edu/ai-definitions/what-is-model-drift. Acesso em: 24 out. 2026.
- YAO, Shunyu et al. ReAct: synergizing reasoning and acting in language models. In: INTERNATIONAL CONFERENCE ON LEARNING REPRESENTATIONS, 11., 2023, Kigali. Proceedings […]. [S. l.]: ICLR, 2023. Disponível em: https://arxiv.org/abs/2210.03629. Acesso em: 24 out. 2026.
Leave a Reply